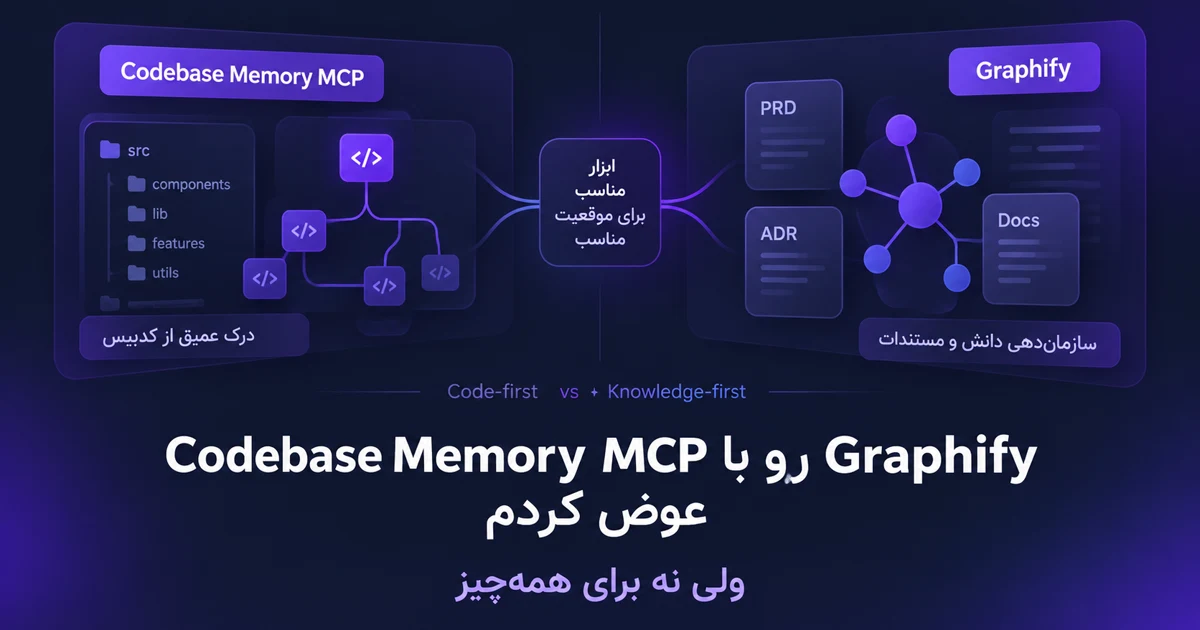
Graphify رو با Codebase Memory MCP عوض کردم؛ ولی نه برای همهچیز
13 دقیقه مطالعه علی ارغیانی
codebase-memorygraphifyهوش-مصنوعیmcpnuxt
چند روز بیشتر از وقتی که مقاله قبلیم درباره Graphify رو منتشر کردم نگذشته بود که Graphify رو از workflow اصلی همین پروژه کنار گذاشتم.
از بیرون شاید عجیب به نظر برسه.
چند روز قبل داشتم میگفتم تجربه خوبی بوده، بعد الان اومدم بگم یه ابزار دیگه رو جاش گذاشتم؟
ولی ماجرا این نبود که Graphify بد از آب دراومد و من رفتم دنبال یه چیز بهتر.
اتفاقاً برعکس.
همین کار کردن با Graphify باعث شد تازه دقیقتر بفهمم اصلاً از این مدل ابزارها چی میخوام.
اول فکر میکردم مشکل اینه که Agent برای فهمیدن پروژه زیادی Search میکنه.
بعد دیدم Search فقط یه تیکه از ماجراست.
مشکل اصلی برای من این بود که تقریباً هر تسک جدید با یه کار تکراری شروع میشد:
دوباره باید شکل پروژه رو میفهمیدیم.
این کامپوننت کجاست؟
کجا mount شده؟
این composable رو چه چیزهایی استفاده میکنن؟
این route به کجا میرسه؟
این feature دقیقاً بین چه فایلهایی پخش شده؟
Graphify این قسمت رو برام خیلی بهتر کرد. قبل از اینکه کورکورانه بین فایلها بچرخم، یه نقشه داشتم.
همین تجربه باعث شد یه سؤال جدید برام جدی بشه:
اگه همین نقشه بیشتر وارد خود workflow کدنویسی بشه چی؟
اینجا بود که رفتم سراغ Codebase Memory MCP.
قبل از مهاجرت، Graphify روی پروژه من دیگه یه تست کوچیک نبود.
گراف رسیده بود به:
قبل از اینکه چیزی رو پاک کنم، کل خروجی رو آرشیو کردم و چندتا کوئری مشخص هم گرفتم که بعداً اگه خواستم مقایسه کنم، مجبور نباشم از روی حافظه حرف بزنم.
سه کوئری نمونه روی سیستم من حدود ۴۷۴ تا ۷۵۳ میلیثانیه جواب میدادن.
یعنی مشکل این نبود که Graphify کار نمیکرد.
کار میکرد.
و اتفاقاً یه چیز خیلی مهم هم بهم یاد داده بود:
لازم نیست هر بار برای فهمیدن یه feature اول نصف repo رو بخونیم.
چیزی که عوض شد، جنس سؤالهایی بود که بیشتر میپرسیدم.
پورتفولیوی من در درجه اول یه پروژه کدنویسیه.
Nuxt، Vue، TypeScript، component، composable، route، server handler و یه عالمه ارتباط بین اینا.
بیشتر وقتها سؤال من این نیست که:
«چرا این تصمیم چند ماه پیش گرفته شده؟»
بیشتر سؤالهام این شکلیان:
«این کامپوننت دقیقاً کجا استفاده شده؟»
«اگه این composable رو تغییر بدم، کجا ممکنه خراب بشه؟»
«این feature از چه فایلهایی تشکیل شده؟»
«این function رو چی صدا میزنه؟»
برای این جنس کار، Codebase Memory به workflow روزمره من نزدیکتر بود.
Codebase Memory از طریق MCP یه سری ابزار مستقیم میده دست Agent.
یعنی وسط همون session کدنویسی میتونه درباره معماری پروژه سؤال کنه، graph رو Search کنه، code search بزنه، path رو trace کنه، coverage رو ببینه یا impact تغییرات رو بررسی کنه.
برای من این فرق مهمی بود.
Graph دیگه یه چیز جدا کنار workflow نبود.
خودش شده بود یکی از ابزارهای Agent.
بعد از index کردن پروژه، CBM برای همین repo این عددها رو داد:
ولی خیلی زود فهمیدم این عددها خیلی مهم نیستن.
چیزی که مهمه اینه که وقتی سؤال واقعی میپرسم، جواب به درد میخوره یا نه.
معماری بلاگ دوزبانه رو خوب پیدا کرد.
مسیر PDF رزومه رو تا حد خوبی پیدا کرد.
usePortfolioSeo
ولی همون اول چند جا هم کم آورد.
مثلاً server route مربوط به
/api/resume/pdf
یا
trace_path
همین خیلی زود یه قانون برام ساخت:
اگه چیزی رو graph پیدا نکرد، حق ندارم نتیجه بگیرم که وجود نداره.
مخصوصاً توی Nuxt که کلی چیز با convention و auto-import ساخته میشه.
اولین تست واقعی بعد از restart اصلاً خوب پیش نرفت.
Toolهای CBM داخل Codex دیده میشدن.
list_projects
Transport closed
index_status
get_graph_schema
راحتترین راه این بود که بگم خب CLI کار میکنه، پس خود CBM سالمه و بریم جلو.
ولی این دقیقاً همون چیزی بود که نمیخواستم توی تستم اتفاق بیفته.
من CBM رو آورده بودم که داخل Codex و از طریق MCP ازش استفاده کنم.
اگه CLI کار میکرد ولی MCP نه، برای چیزی که من میخواستم migration هنوز موفق نبود.
پس verdict همون موقع خیلی ساده شد:
FAIL
بعد شروع کردم دقیقتر بفهمم مشکل کجاست.
Index سالم بود.
Binary درست بود.
CLI کار میکرد.
raw MCP هم initialize میشد، toolها رو میدید و حتی tool call واقعی هم جواب میداد.
کمکم معلوم شد مشکل بیشتر دوروبر session و transport خود Codex/MCP بوده تا خراب بودن graph.
بعد native callهای Codex دوباره شروع کردن به کار.
ولی یه session موفق برام کافی نبود.
سه بار Codex رو کامل بستم و از یه session تازه همون sequence رو اجرا کردم.
هر سه بار پاس شد.
اولین
list_projects
index_status
get_architecture
search_graph
این عددها رو مستقیم کنار benchmark Graphify نمیذارم، چون شرایط اجرا یکی نیست.
چیزی که برام مهم بود این بود که سه clean start پشتسرهم workflow واقعی رو سالم نگه داشتن.
بعد از اون migration رو commit کردم.
برای من نصب شدن یه ابزار تقریباً هیچ معنیای نداره. وقتی میگم migration موفق شده که همون workflowای که قراره هر روز ازش استفاده کنم، واقعاً پایدار کار کنه.
بعد از این همه تست دیگه واقعاً حوصله benchmark مصنوعی نداشتم.
یه کار واقعی روی سایت داشتم.
نسخه موبایل Header خوب نبود.
فضا کم بود، Language Selector زیادی جا میگرفت، Navigation و Theme و انتخاب زبان همه داشتن برای چند سانتیمتر عرض صفحه با هم دعوا میکردن.
در عین حال میخواستم Bottom Navigation درست داشته باشم و نسخه دسکتاپ هم تقریباً همون چیزی بمونه که بود.
این شد اولین تسک واقعی من با CBM.
قبل از اینکه شروع کنم فایلها رو یکییکی باز کنم، از graph خواستم محدوده کار رو پیدا کنه.
خیلی سریع رسید به:
TopNav
LanguageSwitcher
ThemeCustomizer
default layout
useSectionObserver
BottomNav
بعد یه چیز جالب مشخص شد.
من از قبل
BottomNav.vue
فقط اصلاً توی layout mount نشده بود.
این کشف ساده بود، ولی واقعاً روی تصمیم پیادهسازی اثر گذاشت.
اگه مستقیم از روی Screenshot شروع میکردم، خیلی راحت ممکن بود یه Bottom Navigation جدید از صفر بسازم.
در عوض رفتم همون چیزی رو که از قبل توی پروژه بود بررسی کردم، refactorش کردم و آوردمش توی layout.
این دقیقاً همون کاریه که از چنین ابزاری میخوام.
نمیخوام feature رو بهجای من بسازه.
میخوام قبل از اینکه دست به کد بزنم، بهم بگه:
«صبر کن، اینجا از قبل یه چیزی داری.»
آخر کار این feature ده فایل پروژه رو تغییر داد.
Header و BottomNav و LanguageSwitcher که مشخص بودن.
ولی Theme، Layout، منطق scroll، CSS مربوط به fixed navigation، ترجمههای فارسی و انگلیسی و حتی Work Experience هم تغییر خورد؛ چون Timeline توی عرض ۳۲۰ پیکسل باعث horizontal overflow میشد.
CBM برای پیدا کردن محدوده اولیه کار خوب بود.
ولی وقتی خواستم impact نهایی رو ببینم، تصویرش خیلی کامل نبود.
detect_changes
درحالیکه چیزی که کاربر میدید خیلی فراتر از این بود:
اینجا یه فرق مهم برام روشن شد.
Dependency از دید کد همیشه همون dependency از دید UI نیست.
Graph میتونه بگه
useSectionObserver
ولی نمیتونه صفحه رو روی عرض ۳۲۰ پیکسل باز کنه و بگه این Timeline کل viewport رو داره میکشه کنار.
اون قسمت هنوز کار Browserه.
در نهایت صفحه رو روی ۳۲۰، ۳۷۵، ۳۹۰، ۴۳۰، ۷۶۸، ۱۰۲۴ و ۱۴۴۰ پیکسل چک کردم؛ هم انگلیسی و LTR و هم فارسی و RTL.
یعنی CBM کمک کرد زودتر بفهمم کجاها رو باید ببینم.
ولی درست بودن نتیجه رو خودش ثابت نکرد.
اگه بخوام ته این تجربه فقط بگم «CBM بهتر از Graphifyه»، به نظرم کل نتیجه رو خراب کردم.
چون چیزی که الان بیشتر از قبل برام روشن شده، اینه که این دوتا ابزار دقیقاً یه مسئله رو حل نمیکنن.
Overlap دارن، ولی نقطه قوتشون یکی نیست.
سؤال درست برای من دیگه این نیست که:
«Graphify بهتره یا CBM؟»
سؤال درستتر اینه:
پروژهای که دارم باهاش کار میکنم بیشتر کدمحوره یا دانشمحور؟
این فرق خیلی مهمه.
مثلاً همین پورتفولیو.
اصل پروژه کده.
وقتی روش کار میکنم، بیشتر درگیر implementation فعلیم.
میخوام بدونم:
برای این شرایط CBM برای من انتخاب طبیعیتری شده.
چون نزدیک خود Agentه و سؤالها هم مستقیماً درباره codebase هستن.
اگه یه پروژه Nuxt، React، backend service، API یا library داشته باشم که بیشتر کارم implementation، debugging و refactor باشه، الان احتمالاً اول سراغ CBM میرم.
من CBM رو بیشتر شبیه نقشه implementation فعلی پروژه میبینم.
اینجا جاییه که هنوز Graphify رو خیلی جدی میبینم.
فرض کن یه پروژه داری که کنار کد، این چیزها هم واقعاً مهمن:
اینجا اگه فقط کد رو بفهمی، هنوز نصف پروژه رو نفهمیدی.
خیلی وقتها سؤال اصلی این نیست که:
«این function رو چی call میکنه؟»
سؤال اصلی اینه:
«اصلاً چرا این flow این شکلی طراحی شده؟»
«این rule از کدوم PRD اومده؟»
«این تصمیم معماری کجا گرفته شده؟»
«Implementation فعلی هنوز با ADR قبلی هماهنگه؟»
«این constraint بیزینسی از کجا اومده؟»
«این مفهوم بین چند repo و چند document کجاها تکرار شده؟»
اینجا Graphify یه ارزش دیگه پیدا میکنه.
چون فقط کد رو نگاه نمیکنه.
میتونه code رو کنار docs، PDF، image و بقیه محتوای semantic بذاره و ازش یه knowledge graph بسازه.
برای این مدل پروژهها من Graphify رو بیشتر به چشم نقشه دانش پروژه میبینم.
نه صرفاً نقشه کد.
CBM بیشتر جواب این سؤال رو میده که «الان implementation واقعاً چه شکلیه؟»
Graphify وقتی برام جذابتر میشه که سؤال بره سمت «چرا سیستم این شکلی شده و دانش پشت این تصمیمها کجاست؟»
این قسمت به نظرم از همه جالبتره.
اگه پروژه بهاندازه کافی بزرگ باشه، اصلاً بعید نمیدونم Graphify و CBM رو کنار هم استفاده کنم.
ولی نه به این شکل که هر دو رو بندازم روی کل پروژه و دو نسخه از یه graph بسازم.
این کار بیشتر دردسر درست میکنه.
دو graph داری.
دو lifecycle برای update داری.
و برای یه سؤال ممکنه دو جواب متفاوت بگیری.
اگه بخوام هر دو رو داشته باشم، اول ownershipشون رو جدا میکنم.
برای چیزهایی مثل:
اول میرم سراغ CBM.
برای چیزهایی مثل:
Graphify برام انتخاب منطقیتریه.
یعنی اگه CBM جواب بده:
«الان این feature توی کد چطور کار میکنه؟»
Graphify میتونه کمک کنه بفهمم:
«اصلاً چرا این feature این شکلی طراحی شده؟»
این دوتا سؤال یکی نیستن.
این بخش برام خیلی مهمه.
اگه سؤال درباره implementation باشه، آخرش سورس رو باز میکنم.
اگه سؤال درباره requirement باشه، خود PRD رو میخونم.
اگه درباره یه تصمیم معماری باشه، ADR رو چک میکنم.
اگه درباره رفتار واقعی برنامه باشه، برنامه رو اجرا میکنم.
Graph کمک میکنه سریعتر برسم به چیزی که باید چک کنم.
ولی جواب نهایی رو از خودش قبول نمیکنم فقط چون توی graph دیده شده.
احتمالاً چیزی شبیه این:
Codebase Memory
├── frontend repo
├── backend repo
└── shared packages

Graphify
├── PRDs
├── ADRs
├── architecture docs
├── research
├── business/domain docs
├── PDFs and diagrams
└── cross-repository concepts
حالا اگه Agent بخواد بفهمه یه composable چه مصرفکنندههایی داره، میره سراغ CBM.
اگه بخواد بفهمه چرا اصلاً اون feature ساخته شده یا requirement اصلیش چی بوده، میره سراغ Graphify.
این مدل برای من خیلی معنیدارتره تا اینکه هر دو ابزار همون ۵۰۰ فایل رو دوباره index کنن.
یه پروژه کوچیک با چند component و یه README؟
من دلیلی نمیبینم فقط چون دو ابزار خوب داریم هر دو رو نصب کنیم.
اگه ۹۰ درصد پروژه کده و docs فقط چندتا فایل معمولیان، احتمالاً CBM بهتنهایی کافیه.
برعکس، اگه یه repo بیشتر محل PRD، Research، تصمیمهای محصول و مستنداته و کد موضوع اصلی نیست، Graphify منطقیتره.
استفاده همزمان هر دو وقتی برام معنی پیدا میکنه که واقعاً دو corpus مهم داشته باشم:
یکی implementation،
یکی knowledge.
و هر دوتاشون اونقدر بزرگ باشن که جهتیابی توشون خودش تبدیل به هزینه شده باشه.
تقریباً اینطوری نگاه میکنم:
| جنس پروژه | انتخاب اولیه من |
|---|---|
| بیشتر کد و implementation | Codebase Memory |
| بیشتر PRD، Doc، Research و دانش دامنه | Graphify |
| هم codebase جدی، هم knowledge base جدی | هر دو، با مرزبندی مشخص |
| پروژه کوچیک و ساده | احتمالاً فعلاً هیچکدوم |
این جدول benchmark علمی نیست.
فقط نتیجهایه که فعلاً بعد از استفاده واقعی از هر دو برای خودم گرفتم.
ممکنه چند ماه دیگه خود ابزارها تغییر کنن و نظر من هم عوض بشه.
برای همین پورتفولیوی Nuxt، CBM فعلاً ابزار اصلی code intelligence منه.
وقتی یه تسک میاد:
اول با CBM میفهمم مسئله کجا زندگی میکنه.
بعد فایل واقعی رو باز میکنم.
بعد تغییر رو انجام میدم.
بعد اگه لازم باشه impact و coverage رو بررسی میکنم.
و آخرش نتیجه واقعی رو تست میکنم.
اگه UI باشه، توی Browser.
اگه backend باشه، با test و runtime.
اگه Nuxt magic وسط ماجرا باشه، از اول فرض میکنم ممکنه graph همه رابطهها رو ندیده باشه.
ولی اگه همین پروژه فردا پر بشه از PRD، ADR، Research، سندهای معماری و تصمیمهایی که باید ماهها و سالها قابل جستوجو بمونن، خیلی راحت ممکنه Graphify رو دوباره برگردونم.
این بار نه بهعنوان رقیب CBM.
بهعنوان یه لایه دیگه با یه مسئولیت متفاوت.
برای من هیچکدوم.
و فکر میکنم این جواب بهتره.
Graphify باعث شد اصلاً بفهمم داشتن یه project map چقدر میتونه کار با Agent رو بهتر کنه.
CBM نشونم داد برای یه codebase فعال، این نقشه اگه مستقیم داخل workflow کدنویسی باشه میتونه کاربردیتر بشه.
بعد خود CBM هم خیلی سریع نشون داد که graph قرار نیست جادوی Nuxt رو کامل بفهمه یا جای Browser رو بگیره.
چیزی که آخر این تجربه برای من مونده اینه:
یه پروژه کدنویسی به نقشه implementation نیاز داره.
یه محصول جدی به نقشه دانش و تصمیمهاش هم نیاز داره.
گاهی یه ابزار برای هر دو کافیه.
گاهی بهتره این دوتا رو جدا نگه داریم.
برای پورتفولیوی من، الان CBM کافیه چون پروژه خیلی کدمحوره.
برای پروژهای که PRD، ADR، Research و domain knowledge بخش مهمی ازش باشن، Graphify رو هنوز انتخاب خیلی جدیتری میدونم.
و برای پروژهای که هر دو دنیا رو واقعاً داشته باشه، استفاده همزمان از هر دو کاملاً برام منطقیه؛ فقط با یه شرط:
CBM مسئول کد فعلی باشه، Graphify مسئول دانش و دلیل تصمیمها، و من هم یادم نره برای جواب نهایی باید برگردم سراغ منبع اصلی.